Hva gjør MAMMAL så imponerende?
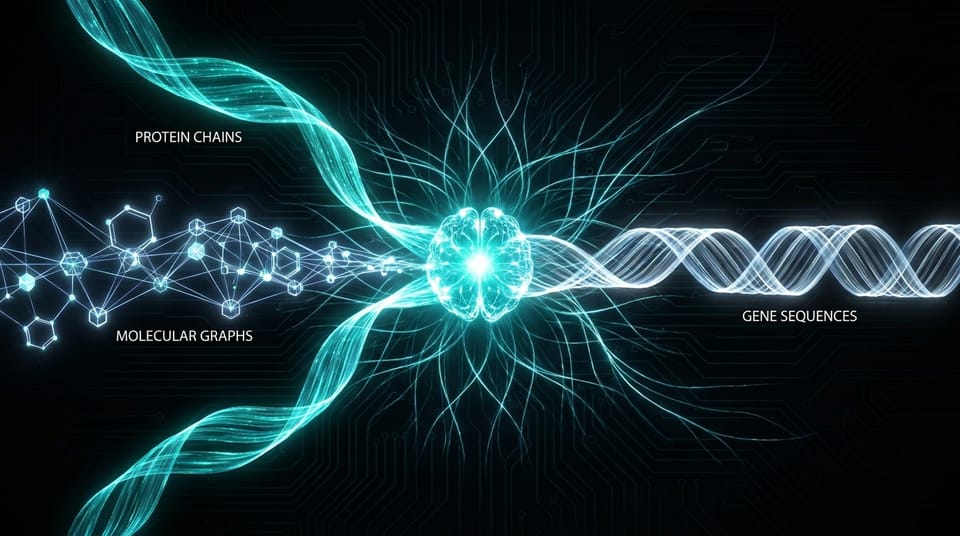
En IBM-modell trent på 2 milliarder biologiske eksempler klarer å forene proteiner, molekyler og genuttrykk i én og samme språkmodell – og slår spesialiserte modeller på ni av elleve benchmarks i drug discovery-pipelinen.
Et treningsgrunnlag på tvers av hele biologien
MAMMAL – kort for Molecular Aligned Multi-Modal Architecture and Language – er utviklet av IBM Research og trent på over 2 milliarder biologiske eksempler: protein- og antistoffsekvenser, små molekyler og enkeltcelle-genuttrykksdata. Det er et reelt tverrsnitt av de største biologiske datakildene som finnes, samlet i én treningsprosess i stedet for spredt over separate, spesialiserte systemer.
En felles representasjon for flere domener
Molekylære strukturer, genuttrykksdata og proteinkjeder har historisk levd i hver sin verktøykasse, med egne dataformater og egne modeller. MAMMAL omformer alt dette til én enhetlig språkmodell-representasjon med en fleksibel prompt-syntaks som lar modellen kombinere tokens og tallverdier på tvers av domener. Det gjør det mulig å stille spørsmål som strekker seg over flere biologiske lag samtidig – for eksempel om et bestemt antistoff sannsynligvis binder seg til et gitt proteinmål.
Bedre prediksjoner på tvers av oppgaver
Den enhetlige representasjonen gir konkrete resultater: på tvers av elleve benchmarks som dekker ulike steg i legemiddelutviklingens pipeline, oppnår MAMMAL beste resultat på ni av dem. Det er et tydelig signal om at en bred, multimodal tilnærming kan slå smalere, oppgavespesifikke modeller – ikke bare på én enkelt oppgave, men gjennomgående over flere samtidig.
Det er samtidig verdt å ha en nøktern forventning: dette er en forskningsmodell gjort tilgjengelig for forskningsbruk, ikke et ferdig medisinsk verktøy. Benchmark-resultater i drug discovery oversettes ikke automatisk til virkning i klinikk – det krever fortsatt laboratorievalidering før noe av dette rører en pasient.
Oppsummering
Bredden i treningsdataene og den enhetlige representasjonen er kjernen i hvorfor MAMMAL presterer som den gjør. Modellen er et konkret eksempel på at åpen, samlet biomedisinsk infrastruktur kan gi bedre resultater enn fragmenterte spesialistverktøy – men den erstatter ikke eksperimentell etterprøving. Les videre om hva modellen betyr for medisinutvikling, bruk i kreftforskning og design av proteinbaserte legemidler.
Ressurser
- MAMMAL på GitHub (BiomedSciAI/biomed-multi-alignment) – kildekode og modellvekter
- IBM Research – Biomedical Foundation Models – bakgrunn fra IBM
- Relatert: AI i vitenskapens tjeneste


